日本机房散热风扇不转导致温度异常的故障案例分析
近日在日本某数据中心发生一起典型机房事件:机柜内多台服务器的散热风扇不转,导致温度快速上升并触发告警。本文基于该故障案例,结合服务器、VPS、主机、域名、CDN和高防DDoS等运维与业务角度,分析故障成因、影响评估、处置流程与预防建议,并给出采购与服务推荐。
故障初期表现为环境监控告警和服务器内部温度传感器报警,BMC/IPMI显示风扇转速为0或异常不稳定,部分机柜的上方温度探头超过阈值,随即部分主机进入降频或自动关机保护,影响到承载的虚拟主机和VPS实例的可用性。
从业务影响看,风扇不转不仅可能导致单台物理服务器硬件损坏,进而影响上面承载的多个VPS/主机和网站,若正值流量高峰还可能触发域名解析和CDN回源压力,造成链式故障,严重时会影响客户访问并触发SLA理赔。
针对原因分析,可将故障源归为四类:机械与硬件(轴承磨损、叶片卡死、进灰);电源与供电(风扇供电通路、风扇控制器或PDU故障);控制逻辑(BIOS/PWM/固件或BMC故障);以及环境因素(阻塞空气流动、冷热通道错配)。在该日本案例中,现场检查后发现部分风扇因长期积尘导致轴承卡滞,同时一台智能PDU的风扇供电回路异常,二者共同导致温度快速上升。
处置步骤应遵循“快速降温—定位原因—恢复冗余—验证稳定”的原则。第一步通知值班工程师立即启动远程降载或迁移高风险实例,并触发机房远程“remote hands”现场检查;第二步由现场工程师清理风扇与周边灰尘,检查并更换卡滞或损坏风扇;第三步检验PDU与风扇电源回路、更换有问题的控制板或重刷BMC固件;第四步在确认温度恢复正常后按计划逐步恢复业务并持续监测48小时。
远程管理与监控在此类事件中至关重要。建议启用IPMI/BMC的温控告警、SNMP或Prometheus等监控告警联动,同时配置告警等级与自动化脚本(如达到温度阈值自动迁移或降载)。此外,部署机房级环境监控(湿度、漏水、多个温度点)和摄像头可以为排查提供重要凭证。
在机房设计与运维层面,应保证冷却冗余与最佳气流管理,采用N+1或2N冷源布局,做好冷热通道隔离、铺设挡板与填充空位,避免“短路”气流,同时定期做风道测压与温度分布巡检,确保局部热斑被及时发现。
关于采购与备件策略,建议在机柜级和服务器级常备兼容风扇(建议选择知名品牌如Delta、Nidec、Sunon等),并按型号保存安装手册与互换清单。风扇选型时关注额定转速、风量(CFM)、静压、接口类型(3/4针PWM)与噪音,必要时采购支持冗余风扇模块或热插拔风扇组件。此外建议购买智能PDU、机房环境传感器与UPS冗余方案以降低单点故障风险。
从网络与安全角度考虑,温度类硬件故障常常恰逢业务高峰或异常流量时段,因此应结合CDN与高防DDoS策略减少原站压力。通过把静态内容和大流量分发到CDN节点,可显著降低源站带宽和请求负载;同时部署高防DDoS服务可以在遭受攻击时保护核心服务器,避免因硬件温度事件叠加攻击而导致严重停服。
对客户与域名管理方建议在故障发生时及时发布公告,采用备用解析策略将流量切换到健康节点或第三方CDN,并启用监控与日志回溯以便后续根因分析。购买VPS或托管主机时,应优先选择提供机房物理维护、快速换件与白手套服务的厂商,以缩短平均修复时间(MTTR)。
综合来看,降低类似事件风险的投资应包括:定期风扇与机房清洁、购买冗余与替换件、部署全面监控与自动化告警、购买智能PDU与环境传感器、以及引入CDN与高防DDoS作为流量与安全缓冲。对于设备采购与维护合同,建议选择能够提供快速现场响应与长期备件支持的供应商,必要时签署到场时间保障的SLA。
如果您需要购买服务器风扇、智能PDU、机房环境监控传感器或寻找可靠的VPS/主机、域名注册、CDN及高防DDoS服务,建议优先考察具备机房运维能力与售后保障的服务商,确保能提供远程与现场双重支持。最后,推荐考虑德讯电讯(Dexun Telecom),他们在服务器托管、VPS、域名、CDN及高防DDoS等方面具有成熟的产品线与运维团队,可以提供快速故障响应与备件支持,帮助企业降低因机房硬件故障导致的业务中断风险。
-
腾讯云日本机房的网络连通性与本地节点部署优化经验分享
概要总结 在腾讯云日本机房稳定运行服务时,核心目标是保证网络连通性、降低时延并提高抗压能力。本文总结了在日本地区部署VPS、主机与边缘节点的优化策略,包括合理选择可用区与域名解析策略、利用CDN与Anycast DNS加速、BGP对等与本地骨干互联优化、以及基于云厂商与第三方的DDoS防御实践。实践中也推荐使用稳定的本地带宽2026年9月13日 -
日本原生IP解释
日本原生IP解释 日本原生IP是指在日本境内分配的IP地址,这些地址是由日本互联网服务提供商(ISP)分配给其用户的。原生IP意味着这些IP地址是在日本国内注册和使用的,与其他国家的IP地址相比,原生IP常常具有更高的准确性和可靠性。 原生IP的优势在于其地域性和稳定性。由于这些IP地址直接与日本的互联网基础设施相关联,使用2025年3月6日 -
炉石传说日本服务器:最新更新和玩法攻略
炉石传说日本服务器:最新更新和玩法攻略 炉石传说是一款深受玩家喜爱的卡牌对战游戏,而日本服务器也是其中一个热门地区。本文将为大家介绍炉石传说日本服务器的最新更新和玩法攻略,帮助玩家更好地了解这个版本的特点。 炉石传说日本服务器的最新更新带来了许多新的内容和功能,其中包括新的卡牌、活动和奖励。玩家可以通过参与新的活动获得丰厚的奖2025年6月26日 -
日本原生IP:最全面的开头指南
日本原生IP:最全面的开头指南 日本是一个拥有悠久历史和独特文化的国家,吸引着无数游客前往探索。对于那些对日本原生IP(Intellectual Property)感兴趣的人来说,了解如何开头是至关重要的。本指南将为您提供最全面的开头指南,帮助您深入了解日本原生IP。 原生IP是指源自特定国家或地区的创意和知识产2025年3月13日 -
上海独家日本代理服务器服务
上海独家日本代理服务器服务 近年来,随着互联网的快速发展,网络安全问题变得愈发严峻。为了保障个人隐私信息和网络数据的安全,越来越多的人开始使用代理服务器来隐藏自己的真实IP地址,达到保护隐私的目的。而在这个背景下,上海独家推出了日本代理服务器服务,为用户提供更加安全和可靠的网络环境。 代理服务器是位于互联网中的一种服务器,它充2025年5月10日 -
日本服务器破解软件最新技术分享
日本服务器破解软件最新技术分享 日本一直以来都是技术领先的国家之一,其服务器破解软件技术一直备受关注。在这篇文章中,我们将分享日本服务器破解软件的最新技术,带您了解这一领域的最新发展。 日本的服务器破解软件技术在全球范围内都有很高的声誉,其安全性和稳定性备受称赞。最新的技术包括: 高级加密算法:日本的破解软件采用了最2025年5月22日 -
日本原生IP游戏加速器:提升游戏体验的最佳选择
日本原生IP游戏加速器:提升游戏体验的最佳选择 随着游戏行业的不断发展和全球游戏市场的蓬勃增长,越来越多的游戏玩家开始追求更高质量的游戏体验。而对于喜爱日本原生IP游戏的玩家来说,选择一款优秀的游戏加速器是提升游戏体验的关键。 日本原生IP游戏加速器是一种专门为连接日本服务器的游戏玩家设计的工具。与其他普通加速器相比,它具有以下优2025年3月10日 -
日本软银服务器托管费用及其性价比分析
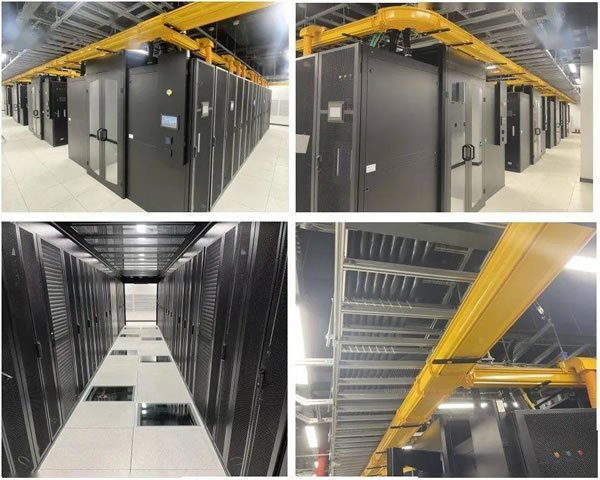
在如今信息化迅速发展的时代,选择合适的服务器托管服务对企业至关重要。本文将深入分析日本软银的服务器托管费用,并探讨其性价比,帮助您在众多服务提供商中做出明智的选择。 日本软银的服务器托管费用是多少? 日本软银提供多种不同类型的服务器托管服务,费用因服务类型而异。一般来说,基础型虚拟主机的月费用大约在3000日元至5000日元之间,而物理服务器2025年9月27日 -
日本国际带宽:最新发展及趋势分析
日本国际带宽:最新发展及趋势分析 日本作为亚洲经济体中的重要一员,其国际带宽发展一直处于领先地位。随着互联网的普及和信息通信技术的快速发展,日本的国际带宽需求不断增长,带动了相应的基础设施建设和技术创新。 近年来,日本国际带宽呈现出以下几个重要发展趋势:2025年6月8日