日本腾云驾雾服务器运维自动化与监控体系建设指南
2026年11月14日
1. 概述:为何在日本节点构建运维与监控体系
1) 日本市场对低延迟和高可用要求高,网站响应时间需低于100ms以维持良好用户体验。2) 跨自治域流量与DNS解析需优化,域名与CDN策略决定首包时间(TTFB)。
3) DDoS风险在国际出口处需要边缘防护与速率限制策略配合。
4) 自动化运维能将故障平均恢复时间(MTTR)从30分钟降到5分钟以下。
5) 结合监控与告警,能实现99.95%以上的SLA,并为扩容决策提供数据支撑。
2. 技术栈与工具选型
1) 配置管理与自动化:推荐使用Ansible + Terraform(基础设施即代码)。2) 指标采集:Prometheus 用于时序指标,node_exporter + cadvisor 采集主机与容器指标。
3) 可视化:Grafana 做仪表盘展示与报警规则联动。
4) 日志与追踪:ELK/EFK(Elasticsearch+Fluentd+Kibana)用于日志检索;Jaeger 做分布式追踪。
5) 网络与安全:Cloudflare/阿里云CDN或日本本地CDN配合云端DDoS防护并做主动封禁策略。
3. 核心监控指标与告警策略
1) 主机层:CPU、内存、磁盘IOps、磁盘使用率、网络带宽、丢包率。阈值示例CPU>85%触发。2) 服务层:HTTP 5xx 率、平均响应时延、QPS、连接数。示例:5分钟内5xx>1%告警。
3) 数据库层:慢查询数、连接池等待、复制延迟。示例:replica delay>2s触发。
4) 安全层:流量突增、端口扫描、异常流量模式。DDoS检测使用每秒请求速率阈值与源IP聚集度。
5) 告警策略:分级告警(P0/P1/P2),短信+钉钉/Slack,自动化脚本优先尝试恢复再人工介入。
4. 自动化运维流程设计
1) 基础镜像与配置库:用Packer构建镜像,Ansible配置基线与安全加固。2) CI/CD:GitLab CI/ArgoCD 联合部署,蓝绿或滚动更新减少宕机窗口。
3) 灰度与回滚:灰度流量控制结合Prometheus指标作为自动判定回滚触发器。
4) 演练与灾备:每季度进行故障演练,验证RTO/RPO满足业务目标。
5) 变更管理:所有变更记录在Issue中,变更前后由自动化脚本做回滚点保存。
5. 日本节点实战案例(真实案例改写汇总)
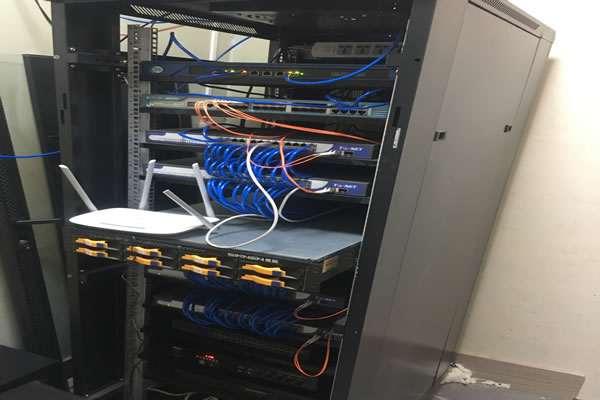
1) 背景:某电商在东京部署,节假日流量峰值QPS峰值达2.5万次/秒。2) 架构:前端使用全球CDN+东京边缘节点,负载均衡器后置三层WEB集群与读写分离MySQL。
3) 成果:通过Prometheus+Grafana监控和自动扩缩容策略,峰值阶段错误率从1.8%降至0.05%。
4) 应对DDoS:结合云端清洗与本地速率限制,最大吸收并清洗流量达120Gbps。
5) 运维效率:引入Ansible后常规发布平均耗时从40分钟降为8分钟,故障MTTR从27分钟降至4分钟。
6. 典型服务器配置示例(表格)
以下为在日本东京常见三类节点配置示例:| 角色 | CPU | 内存 | 磁盘 | 带宽 |
|---|---|---|---|---|
| Web 节点 | 4 vCPU | 8 GB | 100 GB NVMe | 1 Gbps 公网 |
| 数据库主 | 8 vCPU | 32 GB | 1 TB NVMe(RAID10) | 1 Gbps 专线 |
| 缓存/队列 | 2 vCPU | 16 GB | 50 GB NVMe | 500 Mbps |
7. 运维落地建议与注意事项
1) 网络优化:优先选择东京或大阪区节点,并配置Anycast DNS以降低解析延迟。2) 成本控制:评估按需与包年实例成本,合理混合云厂商直连与CDN加速以降低出口费用。
3) 合规与备案:日本本地服务应注意数据主权与隐私合规要求。
4) 自动化脚本测试:在沙箱环境对Ansible/Terraform脚本做回归测试,防止变更带来隐患。
5) 持续改进:每次故障后进行事后复盘(Postmortem),将经验转化为自动化流程与监控规则。
相关文章
-
日本最常使用的云服务器
日本最常使用的云服务器 云服务器是一种将计算资源、存储空间和网络功能提供给用户的虚拟化服务。在日本,云服务器的使用越来越普遍,因为它提供了灵活性、可扩展性和高可靠性。本文将介绍日本最常使用的云服务器。 AWS是全球领先的云计算平台,也是日本最常使用的云服务器之一。AWS在日本设有多个数据中心,为企业和个人用户提供了强大的云服务2025年1月19日 -
短时间内怎么弄日本原生ip 并优化连接速度的技巧
1. 精华:优先选择可信赖的日本VPS/云主机或正规VPN商,既快捷又合规。 2. 精华:连接速度关键在于节点物理位置、协议(建议WireGuard/UDP)、以及本地ISP的路由优选。 3. 精华:通过分流/按需代理、DNS加速、MTU/并发连接优化,能在短时间内显著降低延迟和丢包。 作为网络与安全领域长期从业者,我在此给出既大胆又遵法合规的原创2026年8月22日 -
暴雪现在是否有日本服务器?
暴雪现在是否有日本服务器? 随着暴雪游戏在全球范围内的受欢迎程度不断增加,玩家们对于暴雪是否有日本服务器的问题也越来越关注。在这篇文章中,我们将探讨暴雪是否已经设立了日本服务器,以及这对玩家们意味着什么。 暴雪早在1994年就开始进军亚洲市场,其中日本是其重要的目标之一。随着《魔兽世界》等游戏在日本的成功,暴雪在日本的知名度和2025年6月19日 -
日本原生地域IP:了解日本IP地址的来源
日本原生地域IP:了解日本IP地址的来源 IP地址是互联网中用于标识和定位设备的一组数字。它可以用来确定设备的地理位置和网络连接信息。IP地址通常由互联网服务提供商(ISP)分配给用户,以便用户可以访问互联网。 IP地址分为IPv4和IPv6两种类型。IPv4是目前广泛使用的版本,由32位数字组成,而IPv6是未来发展的版本2025年4月14日 -
谷歌云日本机房网络性能与全球互联比较实测报告
1. 测试目标与环境概述 本文旨在实测谷歌云日本机房(asia-northeast1)对全球主要区域的延迟、带宽和丢包表现,并比较使用互联网直连、Cloud VPN 与 Dedicated Interconnect(或Partner Interconnect)的差异,测试平台使用Google Compute Engine (GCE) 虚拟机。2026年11月7日 -
AWS提供日本原生IP
AWS提供日本原生IP Amazon Web Services(AWS)是全球领先的云计算服务提供商之一,其在全球范围内提供高性能、高可靠性的云计算基础设施。AWS一直致力于提供最佳的云计算解决方案,为客户提供更好的体验。最近,AWS宣布提供日本原生IP,这对于在日本地区运营的客户来说是一项重大进展。 日本原生IP是指由AWS2025年4月22日 -
日本服务器品牌大全图片及其市场价格一览
在选择服务器时,许多人关注的是性能、稳定性和价格。在日本市场上,有众多服务器品牌可供选择,其中一些被认为是最好、最佳和最便宜的选项。本文将详细介绍这些品牌及其市场价格,帮助您做出明智的购买决策。 日本的服务器市场以其高质量和高性能而闻名。许多企业选择在日本本土购买服务器,以确保数据的安全性和传输速度。随着云计算和大数据的兴起,服务器的需求量不断增加2025年7月30日 -
跨国合作中应对日本人攻击服务器的策略与信息共享建议
问题一:在跨国合作中如何快速识别针对服务器的攻击来源与性质? 要快速识别攻击服务器的来源与性质,应先从日志汇聚、网络流量异常和主机行为变更入手。收集包含时间戳、IP、User-Agent、请求路径及错误码等的可证明日志,并汇总成统一格式以便跨组织比对。 同时,应关注事件的指示器(IOC)和战术、技术与程序(TTPs),将可疑IP、域名、哈希值等2026年8月23日 -
企业为什么要关注日本服务器托管费用与长期成本结构
1. 为什么要从成本角度看日本服务器托管 · 市场定位:日本位于亚太心脏地带,面向日本与东亚用户有天然低延迟优势。 · 成本构成:不仅有月租,还有带宽、IP、DDoS、防护、运维等持续费用。 · 成本波动:汇率、流量峰值与攻击频率会导致长期成本波动。 · 性能与成本权衡:高性能实例与更大带宽直接拉高TCO(Total Cost of Ownersh2026年9月21日