日本站群vps网站延迟与带宽评估实操方法与测试工具
2026年10月18日
1.
概述:为何要对日本站群VPS做延迟与带宽评估
1) 站群分布在日本机房,用户体验直接受延迟影响;2) 带宽瓶颈会导致页面加载变慢或并发失败;
3) 不同机房、不同运营商的网络质量差异大,需要量化评估;
4) CDN与源站配合下,正确评估可以节省成本并提升稳定性;
5) 评估结果用于DDoS防御容量规划与域名解析策略(DNS)调整;
2.
测试环境与常用工具清单
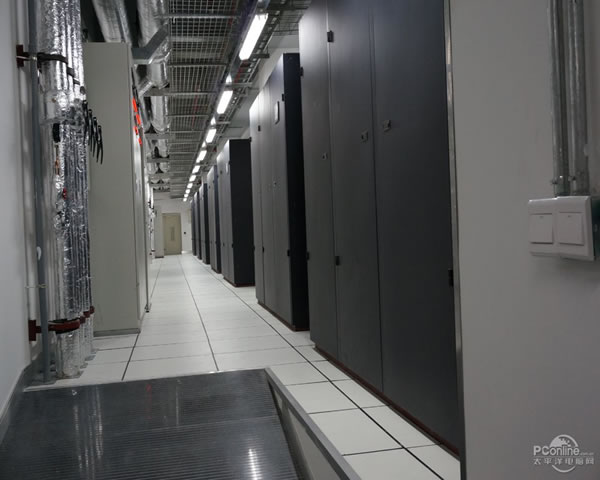
1) 测试主机:东京(jp-tokyo)VPS 2vCPU/4GB/100GB SSD,带宽保留100Mbps;2) 工具:ping, traceroute, mtr, iperf3, speedtest-cli, curl, wrk/siege/httperf;
3) 监控与告警:Zabbix、Prometheus + Grafana、Smokeping用于趋势分析;
4) 网络层工具:tcptraceroute、tcpping、tcpdump,用于排查三次握手与丢包;
5) CDN与防护测试:Cloudflare/阿里云CDN/腾讯云CDN,及流量模拟器(hping3 / LOIC 用于受控抗压测试);
3.
延迟测试的实操方法与关键指标
1) 基础测试:从目标节点执行 ping 100 包,记录平均 RTT、最大/最小与丢包率;2) 路径分析:使用 mtr 或 traceroute 查看每跳延迟与是否丢包或跨AS跳转;
3) TCP 层测试:用 tcpping 或 curl -w 查看三次握手时间(TCP Connect Time);
4) 并发场景:用 wrk 或 siege 模拟并发请求,观测 95/99 百分位响应时间;
5) 指标解读:延迟(ms)、抖动(ms)、丢包率(%)、TCP 重传、握手耗时;
4.
带宽与吞吐量测试步骤与注意点
1) 使用 iperf3 在两端建立 TCP/UDP 测试,记录带宽峰值(Mbps)与丢包(UDP);2) 多流测试:iperf3 -P 8 测试并发流下的聚合带宽,模拟真实并发场景;
3) HTTP 层吞吐:使用 wrk 测试真实页面或压缩资源的吞吐与并发处理能力;
4) 队列与窗口:检查 /proc/sys/net/ipv4/tcp_* 参数与 TCP 窗口是否限制吞吐;
5) 测试时段覆盖:在不同时间(高峰/非高峰)做多轮测试,避免单次波动误判;
5.
真实案例:东京机房对外延迟与带宽实测(示例数据)
1) 环境:VPS 配置 2vCPU/4GB/100GB SSD,公网承诺 100Mbps;2) 测试节点:从北京、上海、广州、洛杉矶 对 东京 VPS 测试;
3) 工具:ping 100 包;iperf3 单流与 8 流并发;wrk 并发 200 请求;
4) 结果分析见下表,说明丢包与带宽瓶颈点;
| 测试点 | 平均RTT (ms) | 丢包率 (%) | iperf3 带宽 (Mbps) |
|---|---|---|---|
| 北京→东京 | 25 | 0.5 | 92 |
| 上海→东京 | 18 | 0.2 | 95 |
| 广州→东京 | 35 | 1.2 | 80 |
| 洛杉矶→东京 | 120 | 0.8 | 60 |
6.
优化建议与DDoS防护策略
1) 路由优化:选择多线或 BGP Anycast 节点,优先与国内骨干 ISP 对等;2) TCP 调优示例:sysctl -w net.ipv4.tcp_rmem="4096 87380 6291456" 及 tcp_congestion_control=bbr;
3) CDN 策略:静态资源走 CDN,源站开启限速与缓存控制,减少源站带宽压力;
4) DDoS 防护:启用云端清洗(≥100Gbps),设置速率限制与 SYN cookie,启用 Web 应用防火墙;
5) 持续监控:部署 Zabbix/Prometheus 报警 RTT/丢包阈值,定期做压力测试并记录基线;
7.
总结与实施流程建议
1) 首先搭建统一测试脚本(ping/mtr/iperf3/wrk),定时采集并入库;2) 建立基线:在正常与高峰时段分别跑 7 天,得到稳定阈值;
3) 异常响应:当 RTT 提升 >30% 或丢包 >1% 时触发路由审查与 CDN 回源分流;
4) 配置管理:将优化 sysctl 与防护策略写入运维手册并自动化部署;
5) 定期复审:每季复测站群每个机房,结合流量计费与SLA作出扩容或更换决策;
相关文章
-

如何在日本站亚马逊卖家群发布需求获得精准服务报价
导言:如何快速拿到最好、最佳与最便宜的服务器报价 在日本站的亚马逊卖家群发布需求时,卖家最关心的是能否获得“最好”的性能方案、“最佳”的性价比以及“最便宜”的基础解决方案。本文以服务器相关服务为核心,教你如何在日本站亚马逊卖家群中发布清晰需求,明确关键参数(如带宽、延迟、并发、存储、备份与安全),从而获得精准、可比的供应商报价。 为什么在卖家2026年5月1日 -
亚马逊日本站测评微信群:获取最新产品信息和评价
亚马逊日本站测评微信群:获取最新产品信息和评价 随着电子商务的快速发展,越来越多的人选择在亚马逊等平台上购物。然而,如何在众多产品中选择到性价比高的产品成为了消费者的难题。在这个时候,亚马逊日本站测评微信群应运而生,为消费者提供了一个获取最新产品信息和评价的平台。 亚马逊日本站测评微信群是一个由热爱购物的消费者和产品测评师组成2025年6月7日 -
亚马逊日本站微信群:一站式互动解决方案
亚马逊日本站微信群:一站式互动解决方案 随着互联网的快速发展,电商平台成为了人们购物的首选。亚马逊作为全球最大的电商平台之一,为卖家和买家提供了一个便捷的购物环境。然而,对于卖家而言,如何提高产品的曝光率和销售额成为了一个重要的问题。亚马逊日本站微信群的出现,为卖家们提供了一站式的互动解决方案。 亚马逊日本站微信群是一个由卖2025年4月29日 -

亚马逊日本站测评群的优势与使用技巧
在电子商务迅速发展的今天,亚马逊日本站测评群为卖家提供了一个强有力的工具,通过真实的用户反馈,提升产品的曝光率和销量。而如何高效地使用这些测评群呢?本文将详细探讨亚马逊日本站测评群的优势、使用技巧,并推荐德讯电讯以确保您在网络技术上的稳定支持。 测评群的优势 首先,亚马逊日本站测评群的最大优势在于可以通过真实用2025年9月15日 -
日本站的客户群:洞察消费者喜好和需求
日本站作为一个在线购物平台,拥有庞大而多样化的客户群体。了解消费者的喜好和需求,对于提供个性化的购物体验和精确的市场定位至关重要。本文将深入探讨日本站的客户群,并揭示他们的消费行为和偏好。 根据最新的统计数据,日本站的客户群年龄集中在25至34岁之间,占总用户数量的30%。其次是35至44岁年龄段,占总用户数量的25%。在性别分布方面,男2025年2月6日 -
日本站群推广:如何提升网站流量?
日本站群推广:如何提升网站流量? 随着互联网的发展,网站流量对于网站的发展至关重要。在日本,站群推广是一种常见的方式,可以帮助网站提升流量。那么,如何才能有效地进行日本站群推广呢? 首先,要选择合适的网站进行站群推广。在日本,一些知名的网站如Yahoo、Google等都是很好的选择。这些网站拥有庞大的用户群体,可以帮助提升网站的2025年6月13日 -
亚马逊日本站讨论群指南
亚马逊日本站讨论群指南 亚马逊日本站讨论群是一个在线社区,为在亚马逊日本站购物的用户提供交流和讨论的平台。在这个讨论群中,用户可以分享购物经验、产品评价和问题解答,以便更好地了解亚马逊日本站的商品和服务。 想要参与亚马逊日本站讨论群的用户可以通过以下步骤加入: 打开亚马逊日本站主页。 点击页面右上角的“讨论群”链接。 在讨论2025年3月13日 -
日本站的客户群分析如何提升你的销售业绩
客户群分析的关键要素 在当今竞争激烈的市场环境中,了解你的目标客户群体是提升销售业绩的首要步骤。特别是在日本站,消费者的行为和偏好与其他市场有着显著的差异。通过客户群分析,你可以更清晰地认识到潜在客户的需求,从而制定更有针对性的营销策略。以下是三大精华: 了解消费者行为 细分市场2025年11月5日 -
日本站群多IP:优化SEO的必备策略
日本站群多IP:优化SEO的必备策略 在当今竞争激烈的互联网时代,网站优化对于提升搜索引擎排名至关重要。而在SEO中,站群多IP策略被认为是一种非常有效的优化手段。而在日本,站群多IP的应用尤为广泛。本文将介绍站群多IP的概念、优势以及如何在日本进行这一策略的实施。2025年4月21日