日本机房起火对业务连续性影响评估与备援策略建议
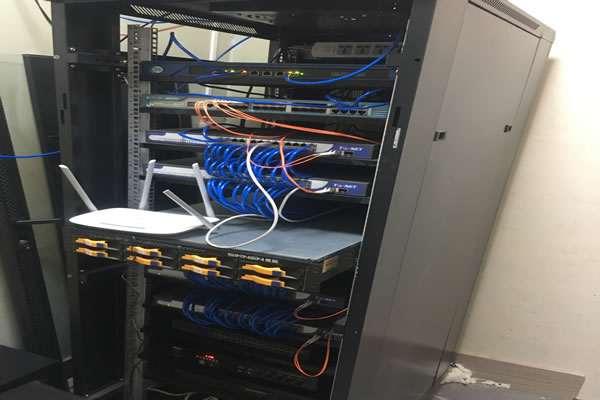
本篇文章围绕近期日本机房起火事件,概述对业务的直接与间接影响,提出评估优先级、关键风险识别方法及可落地的备援与恢复策略,兼顾成本、合规与实施可行性,帮助企业制定切实可行的容灾计划。
有多少业务会受到影响?
评估受影响业务的第一步是梳理依赖清单:列出托管在该机房或经由其网络链路的服务、数据库、存储与中间件。针对每项服务,定义其RTO(恢复时间目标)与RPO(恢复点目标),并以此判断有多少属于高优先级需要立即恢复。通常交易类、支付、核心API与认证系统受影响最严重,其次是数据仓库与分析服务。
哪个环节最脆弱?
机房起火会直接破坏电力、冷却、网络与物理设备,尤以单一机房依赖单一电源、单链路出口或无异地备份的存储系统最为脆弱。应用架构中未做无状态化设计、会话高度依赖本地缓存或同步复制链路的数据库节点也会放大影响,导致连锁故障。
为什么日本机房起火会导致业务中断?
机房起火不仅造成硬件损坏,还可能导致供电中断、网络隔离与冷却失效。同时,监控与运维系统若部署在同一机房,会影响故障检测与恢复决策。法律与合规要求可能限制跨境数据迁移,延长恢复时间;供应链中断也会影响设备更换与外包支持。
哪里应优先部署备用设施?
优先在地理与网络多样性上进行布局:选择不同城市甚至不同国家的备用机房,确保至少一个异地容灾站点(cold/warm/hot standby)可用。关键是网络出口路径要独立,DNS、证书等依赖也应在备用区同步准备,以减少切换时间和人为配置错误。
如何评估影响范围并制定恢复优先级?
结合业务重要性、交易量与法律合规要求,采用分级评估法(A/B/C类)明确恢复顺序。利用演练与桌面演习验证评估结果,量化切换时间与数据丢失风险。对外部依赖(云服务、第三方API)应建立SLA审查与冗余方案,确保第三方中断不会成为单点故障。
怎么制定有效的< b>备援策略?
备援策略应包含技术、运维与沟通三部分:技术上采用多活或热备架构、定期异地快照与日志复制;运维上制定清晰的跑道(runbook)、自动化故障切换与回滚方案;沟通上建立内部与客户的应急通道、发布模板与责任清单。注重定期演练与优化。
如何平衡成本与风险?
根据业务RTO/RPO将系统分为关键/重要/普通三类,关键系统投资高可用与多活,普通系统可采用冷备或云上按需恢复。采用混合云与按需扩展能在降低CAPEX的同时提高弹性。定期评估备援成本与潜在停机损失,计算ROI以指导投入决策。
为什么定期演练和供应链管理很重要?
演练能发现文档与自动化的缺陷,检验第三方响应与物理调拨流程的可行性;供应链管理确保替换设备、维护人员与外包服务在紧急情况下可用。将演练结果纳入改进周期,调整备援优先级与合同条款,确保在实际事件中响应高效且合规。
怎么在法律与合规下执行跨境备援?
理解数据主权与个人信息保护法律,确定哪些数据可跨境迁移。对敏感数据采用加密与脱敏技术,必要时采用只读异地备份或受控访问的异地站点。在合同中明确责任与数据处理条款,确保跨境切换符合法律与监管要求。
如何将建议落地为可执行计划?
制定分阶段实施路线图:短期(30-90天)完成关键服务异地备份与监控优化;中期(3-9个月)建立自动化切换与演练机制;长期(9-18个月)实现多活/混合云架构并完成合规审计。为每一项任务指定负责人、里程碑与验收标准,确保可追踪与持续改进。
-

日本服务器数量排名背后的市场潜力分析
日本是全球技术发展最为迅速的国家之一,服务器的数量和质量直接影响着互联网服务的稳定性和速度。在这篇文章中,我们将深入分析日本服务器数量的排名背后隐藏的市场潜力,并提供实际的操作步骤指南,帮助企业和个人在日本市场中占据一席之地。 1. 日本服务器市场概况 日本的服务器市场近年来呈现出持续增长的趋势。根据最新的市场研究报告,2025年10月11日 -

了解日本专用服务器有哪些型号与配置适合企业级应用
1. 为什么考虑日本专用服务器用于企业级应用 1) 地理优势:日本位于亚太枢纽,对日本国内与亚洲其它市场访问延迟低。 2) 法规及数据主权:部分行业(金融、医疗)要求数据驻留在日本境内。 3) 网络质量:日本机房通常提供千兆/10G骨干互联与优质回程链路。 4) 可定制化:专用服务器能按CPU、内存、存储与带宽做精细化配置。 5) 稳定性与安全2026年8月7日 -

日本机房装修效果图大全 展示的标准化机柜布局与走线细节解析
在这些效果图中,最显著的展示是机柜的行列排列与通道宽度规范。常见的布局包括热通道/冷通道分离、整齐的单向气流通道,以及机柜高度与深度的标准化标注。效果图会标注每排机柜之间的最小通道宽度(通常为1.0米以上以符合维护需求)、机柜前后留缝以及与UPS和配电柜的相对位置。此外,图中还会标示配电线缆入口、空调送回风口和地板承重能力等关键节点,便于设计者在平2026年3月28日 -
企业运营视角 支付宝服务器在日本哪里 对跨境支付的影响分析
概述与核心结论(最佳、最便宜与权衡) 从企业运营角度来看,关于支付宝服务器在日本哪里,最佳方案通常是选择在日本本地或就近亚太节点部署可靠的支付接入点,以获得最低延迟和更好的用户体验;最便宜的方案可能是通过海外公有云(如香港、新加坡)进行接入,但会在合规与延迟上产生权衡。对于企业而言,衡量标准应以跨境支付的稳定性、合规性与成本三者平衡为主。 支2026年9月15日 -
日本服务器工作优势分析
日本服务器工作优势分析 日本作为一个发达国家,其服务器行业也备受关注。本文将对日本服务器工作的优势进行分析,帮助读者更好地了解日本在服务器领域的竞争优势。 日本在技术研发方面一直保持领先地位,尤其在服务器领域。日本公司不断推出新的技术和产品,如高性能服务器、云计算解决方案等,满足不同用户的需求。 日本服务器以其稳定性2025年6月16日 -

获取日本DNS服务器地址的简单攻略
在当今数字化时代,网络的速度和安全性显得尤为重要。尤其对于身处海外的用户,获取日本DNS服务器地址可以帮助提升上网体验。那么,如何简便地获取这些地址呢?以下是我们整理的三大精华攻略: 接下来,让我们逐一深入探讨这三种方法,让你轻松获取日本DNS服务器地址,提升网络访问速度。 1. 选择合适的DNS服务提供商 首先,选择一个可靠的DNS服务提供商是获2025年11月1日 -
日本低价服务器优惠大促销
日本低价服务器优惠大促销 近日,日本知名互联网服务提供商推出了一场低价服务器优惠大促销活动。该活动涵盖了各种类型的服务器,包括共享主机、VPS主机和独立服务器,价格低至每月仅需几十元人民币。 该优惠大促销活动将持续一个月的时间,截止日期为XX年XX月XX日。在这段时间内,用户可以享受到超值的优惠价格,轻松搭建自己的网站或应用2025年5月15日 -
日本口服务器:高效稳定的选项
日本口服务器:高效稳定的选项 日本作为一个发达国家,在互联网和科技领域拥有先进的基础设施和技术。对于那些寻找高效稳定的服务器选项的企业和个人用户来说,日本口服务器是一个值得考虑的选择。 日本口服务器以其高效性而著称。这些服务器采用先进的硬件和软件技术,能够提供快速而稳定的网络连接。无论是在上传还是下载文件,日本口服务器都能够以2025年3月11日 -
conoha日本原生IP:稳定、高速的选择
在互联网时代,稳定和高速的网络连接对于个人和企业来说至关重要。conoha日本原生IP是一种提供稳定、高速连接的选择,它能够满足用户对于网络服务的各种需求。 conoha日本原生IP是由conoha公司提供的一种网络服务。它采用独立的IP地址,不经过中间节点进行转发,直接连接到日本互联网,确保了连接的稳定性和高速性。 conoha日本2025年2月13日