日本站群服务器机房网络优化实践与CDN协同加速经验分享
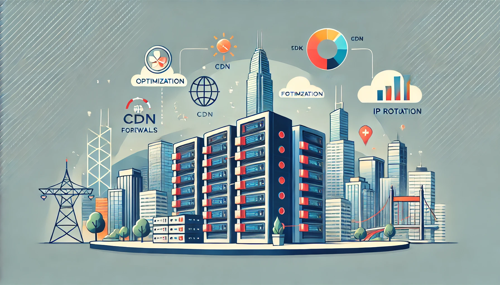
日本站群服务器机房网络优化与CDN协同加速——实战精华
1. 精华:通过机房多点部署+智能BGP调度,显著降低日本本地用户的延迟与丢包。
2. 精华:与CDN紧密联动(边缘缓存、Origin Shield、动态加速),实现高并发下的稳定响应与成本可控。
3. 精华:全链路观测+自动化策略(流量劣化回退、缓存预热与跨机房同步)是保证站群稳定性的关键。
作为在日本长期运营站群的工程团队,我们把每一项优化都落地成度量可见的改进。首先,选择优质的机房与运营商直连(优先考虑NTT、KDDI、SoftBank与主要IX),并在关键城市部署POP,实现本地Anycast出口,降低到达用户的最后一跳延迟。
在网络层面,采用多线BGP策略并结合健康检查与实时路由策略,实现流量按延迟/丢包/成本动态分流。对站群而言,合理划分国内流量与国际出口,避免日本境内流量走回国际链路,从根本上减少不必要的跨境抖动。
与CDN的协同是加速的核心:把静态资源与常用API前置到边缘,同时启用Origin Shield或中继节点以减轻源站压力。我们建议设置分级缓存、合理的Cache-Control与Stale-While-Revalidate策略,并针对登录态/个性化内容使用短TTL+边缘计算或Signed Cookies保证安全与命中率。
传输与安全优化方面,统一启用HTTP/2或HTTP/3,保持TLS会话重用与0-RTT(在可接受的风险范围内),并压缩传输(Gzip或Brotli)。结合WAF、速率限制与IP信誉库,平衡性能与防护,避免被DDoS或爬虫击垮站群。
针对DNS与路由,我们推荐使用具备健康检测的全球DNS/Geo-DNS,配合Anycast与本地DNS缓存策略,缩短解析时间并避免单点回源。此外,为了降低源站负载,引入智能回源策略:当边缘命中率下降时逐级回源并触发预热或限流。
运维自动化同样重要。用Ansible/Terraform统一机房配置、用CI/CD推送边缘规则,并在变更前进行灰度与流量回滚测试。对站群来说,自动化能把人为失误和发版风险降到最低。
观测体系覆盖三层:合成监控(合成脚本定期测点到点延迟/丢包)、真实用户监控(RUM,统计TTFB、首屏时间)、以及服务端指标(Prometheus+Grafana监控QPS、带宽、连接数)。将这些数据与报警、自动换路联动,做到异常秒级响应。
在成本控制上,合理规划边缘缓存策略与带宽包年/包月合同,结合P2P或本地热点同步技术,可在不牺牲体验的前提下降低带宽开销。实战中,我们通常把热点资源在边缘维持高命中率,从而把源站流量降低30%-60%。
最后,安全合规与品牌信任不可忽视。保持日志留存策略、合规审计、定期安全扫描与漏洞响应流程,能为站群长期稳定运行提供保障。同时通过公开SLA与案例数据,提升团队的权威与信任度(符合EEAT的要点)。
总结:把机房选择、BGP/Anycast策略、与CDN的精细化协同、传输层优化、自动化运维与全链路观测结合起来,便能把日本站群的用户体验、稳定性和成本效率同时提升。实测表明,这套方法常见可将p95响应时间下降30%-50%、源站带宽压力下降数十个百分点,是真正能落地的实战路径。
作者:资深站群与网络优化工程师(多年日本机房与CDN部署经验),欢迎针对具体架构索取可复用的配置与自动化脚本。
-

日本站群服务器运维自动化脚本与常见问题排查
本文概述了面向日本站群服务器的运维自动化策略与典型故障排查流程,涵盖脚本语言选择、批量部署与调度、权限和网络差异应对,以及常见问题的定位与修复建议,便于运维团队建立稳定可复用的自动化体系。 当管理规模超过十几台且配置或发布流程重复时,使用自动化运维脚本就能显著降低人工成本与出错率。即便是少量节点,若节点分布在不同日本机房、网络策略或时区也更建议早期2026年5月30日 -

节省成本的日本站群机房带宽优化与CDN部署最佳实践全面指南
问题一:如何准确评估日本站群的机房带宽需求? 评估日本站群带宽首先要做流量画像:统计日均流量、峰值并发、请求类型(静态/动态)和地域分布。结合日志计算峰值吞吐与并发,用95th percentile或峰值并发估算带宽。引入CDN部署后,测算静态资源的缓存命中率、回源比率,可以显著降低机房出站带宽需求。最后选择支持弹性带宽或突发能力的日本机房供应2026年7月3日 -
如何通过压测结果为日本站群服务器选择提供依据
概述:用压测决定最好、最佳与最便宜的日本站群服务器 在为日本站群进行服务器选择时,简单比较价格或只看CPU规格远远不够。通过科学的压测(包括负载、并发、带宽和IO测试),你可以获得决定性的量化依据,判断哪个方案是“最好”(性能最优)、“最佳”(性能与成本平衡)或“最便宜”(满足最低业务需求且成本最低)。本文将围绕如何设计压测、解读关键指标并将结2026年9月3日 -
亚马逊日本站卖家QQ群,快速获取销售信息
亚马逊日本站卖家QQ群,快速获取销售信息 亚马逊日本站是全球最大的电商平台之一,拥有庞大的用户群体和销售机会。作为卖家,了解市场趋势和获取最新的销售信息是非常重要的。而加入亚马逊日本站卖家QQ群,可以快速获取到有关销售的重要信息,帮助卖家更好地开展业务。 加入亚马逊日本站卖家QQ群可以带来以下好处: 及时了解市场动态:在2025年5月2日 -
亚马逊日本站微信群:加入最新资讯和讨论
亚马逊日本站微信群:加入最新资讯和讨论 亚马逊日本站微信群是一个汇集了各种关于在亚马逊日本站销售和购物的讨论和资讯的群体。无论您是想在亚马逊日本站开设店铺,还是想购买来自日本的商品,加入这个微信群将会给您带来很多帮助和信息。 在亚马逊日本站微信群中,您可以获取到最新的关于亚马逊日本站的资讯。这包括亚马逊日本站的政策变化、促销2025年6月18日 -
日本站群服务器高带宽:提升网站效率的最佳选择
日本站群服务器高带宽:提升网站效率的最佳选择 在当今数字化时代,拥有一个高效稳定的网站对于企业和个人都至关重要。而选择一个优质的服务器托管服务是确保网站运行顺畅的关键因素之一。日本站群服务器以其高带宽、稳定性和可靠性成为许多网站主的首选。本文将介绍日本站群服务器的优势,以及为什么它是提升网站效率的最佳选择。 日本站群服务器以其2025年5月20日 -
日本站测评群:专业评测带你畅游日本
日本站测评群:专业评测带你畅游日本 日本站测评群是一个由一群热爱旅行的专业评测人员组成的团队。他们以深入了解日本各地旅游景点、文化特色和美食为目标,为游客提供专业的评测和指导,帮助游客在日本畅游。 1. 专业评测:日本站测评群的成员都是经过严格筛选和培训的专业人士,他们对日本旅游非常了解,能够提供权威的评测和建议。 2. 多2025年1月18日 -

加入亚马逊日本站交流群,获取最新市场动态
在竞争激烈的电商市场中,及时获取最新的市场动态与行业趋势是成功的关键。通过加入亚马逊日本站的交流群,您可以与其他卖家进行交流,分享经验,从而更好地把握市场脉动。这不仅能够提升您的运营能力,也有助于捕捉更多商机。 加入交流群有什么好处? 加入亚马逊日本站交流群,您将获得许多宝贵的资源和信息。首先,您可以实时获取最新的市场动态,包括政策变化、热门2025年8月1日 -
亚马逊日本站卖家QQ群:连接您与亚马逊日本市场的通道
亚马逊日本站卖家QQ群:连接您与亚马逊日本市场的通道 亚马逊日本站作为全球最大的电商平台之一,拥有庞大的市场规模和潜力。对于想要进入亚马逊日本市场的卖家来说,了解市场动态和获取实时信息非常重要。而亚马逊日本站卖家QQ群就是一个连接您与亚马逊日本市场的重要通道。 亚马逊日本市场在全球范围内都备受关注,因为它拥有巨大的消费群体和强大2025年3月27日